

1. 서 론
2. 연구 대상 및 자료
2.1 연구 대상 지역
2.2 PlanetScope 위성 영상
2.3 학습 라벨 생성
3. 연구 방법
3.1 패치 생성 및 데이터셋 분할
3.2 딥러닝 모델
3.3 모델 학습 조건 및 최적화 전략
3.4 평가 지표
4. 결 과
4.1 모델별 분류 성능 비교
4.2 분광지수 기반 학습 라벨 정제 후 결과 비교
4.3 최적 모델(SegFormer) 클래스별 성능
4.4 모델 간 클래스별 성능 비교
4.5 수위 상승 전후 토지피복 분류 결과
5. 고 찰
5.1 모델성능 및 학습 라벨품질에 대한 고찰
5.2 수위 상승 전후 토지피복 변화의 해석과 불확실성
5.3 연구의 한계 및 향후 과제
6. 결 론
1. 서 론
하천 수변구역의 토지피복은 강수량 및 유량 변화, 홍수 사상, 하도 내 퇴적·침식, 인위적 교란 등에 민감하게 반응하는 하천환경의 주요 구성 요소이다. 특히 수체, 나지, 초지 및 목본 식생의 공간적 분포는 하천의 물리적 구조와 생태적 기능을 반영하며, 홍수 이후 하상 변형, 식생 이입, 수변공간 변화 등을 파악하는 데 중요한 기초자료로 활용된다. 따라서 하천 수변구역의 토지피복 변화를 주기적으로 관측하고 정량화하는 것은 하천 관리, 홍수 피해 평가, 하천환경 변화 모니터링을 위한 필수적인 과정이다(Tockner and Stanford, 2002; Allan, 2004; Jeong et al., 2025).
기존의 하천 수변구역 조사는 현장 조사, 항공사진 판독, 수동 디지타이징 등에 의존해 왔다. 이러한 방법은 세밀한 공간정보를 확보할 수 있다는 장점이 있으나, 광범위한 하천 구간을 반복적으로 조사하는 데 많은 시간과 비용이 요구된다. 또한 집중호우 이후 현장 접근성이 제한되는 조건에서는 신속한 자료 취득이 어렵다는 한계가 있다. 이러한 제약으로 인해 하천환경 변화를 시계열적으로 분석하고, 홍수 전후의 수체·나지·식생 면적 변화를 신속하게 파악하기 위한 원격탐사 기반 모니터링 기술의 필요성이 증가하고 있다(Park and Kang, 2022; Konapala et al., 2021).
최근 위성원격탐사 자료의 공간·시간 해상도가 향상됨에 따라 하천 수변구역의 토지피복 변화를 정량적으로 분석할 수 있는 가능성이 확대되고 있다. Google Dynamic World, ESA WorldCover와 같은 전지구 토지피복 자료는 광역적인 토지피복 정보를 제공하여 모니터링 자료의 접근성을 향상시켰다(Brown et al., 2022; Zanaga et al., 2022). 그러나 이들 자료는 주로 10 m 이상의 공간해상도를 기반으로 하므로, 하폭이 좁고 피복 경계가 복잡한 중·소규모 하천의 수변환경을 정밀하게 표현하는 데 한계가 있다. 특히 수체와 나지, 초지와 목본 식생, 도로 및 제방과 같은 선형 객체는 혼합화소 문제의 영향을 크게 받으며, 이로 인해 하천 구역 내 세부 피복 분류의 정확도가 저하될 수 있다(Bizzi et al., 2016; Rivas-Fandiño et al., 2023).
이러한 한계를 보완하기 위해 고해상도 위성영상의 활용이 중요하게 고려되고 있다. PlanetScope 위성영상은 약 3 m의 공간해상도와 높은 재방문 주기를 제공하며, 다중분광 밴드를 활용한 세밀한 지표 특성 분석이 가능하다. 특히 강우 사상 전후의 영상을 비교적 짧은 시간 간격으로 확보할 수 있어, 홍수 이후 수체 확장, 나지 노출, 식생 변화 등 하천 수변구역의 단기 변화를 분석하는 데 유용하다(Cooley et al., 2017; Furuya et al., 2020). 또한 Red Edge 및 NIR 밴드는 식생 활력과 수분 조건을 반영할 수 있어, 하천 내 식생 및 수체 분류의 정확도 향상에 기여할 수 있다.
한편, 원격탐사 기반 토지피복 분류 분야에서는 딥러닝 기반 의미론적 분할 기법이 픽셀 단위 분류를 위한 주요 방법론으로 활용되고 있다. U-Net은 인코더-디코더 구조와 스킵 연결을 통해 공간 정보를 효과적으로 복원할 수 있어 원격탐사 영상 분할에 널리 적용되어 왔다(Ronneberger et al., 2015). Attention U-Net은 attention gate를 통해 분할 대상과 관련성이 높은 공간 특징을 강조하고 불필요한 배경 반응을 억제할 수 있으며(Oktay et al., 2018), DeepLabV3+는 Atrous Spatial Pyramid Pooling과 encoder-decoder 구조를 결합하여 다양한 공간 규모의 문맥 정보와 경계 정보를 함께 반영할 수 있다는 장점이 있다(Chen et al., 2018). 또한 scSE 모듈은 공간 및 채널 단위의 특징 재보정을 통해 fully convolutional network 기반 분할 성능 개선에 활용될 수 있다(Roy et al., 2018). 최근에는 Transformer 기반 구조가 장거리 공간 의존성을 효과적으로 학습할 수 있다는 점에서 원격탐사 영상 분류 분야에 적용되고 있으며, SegFormer는 Mix Transformer 인코더와 경량 디코더 구조를 결합하여 다양한 토지피복 분류 연구에서 우수한 성능을 보인 바 있다(Xie et al., 2021). 국내에서도 딥러닝 기반 위성영상 토지피복 분류 연구가 수행된 바 있으며(Kim et al., 2021), 수변구역을 대상으로 한 의미론적 분할 기법의 적용 가능성이 검토되고 있다(Jeong et al., 2025).
그러나 하천 수변구역은 수체, 나지, 초지, 목본 식생, 도로 및 제방 등이 좁은 공간 내에서 복합적으로 분포하는 특성을 가지므로, 일반적인 도시·농업지역 토지피복 분류와는 다른 분류 난도가 존재한다. 특히 하천 내 피복 요소는 선형적이고 불규칙한 형태를 가지며, 계절 변화와 강우 사상에 따라 단기간 내에 공간적 변화가 발생할 수 있다(Kutz et al., 2022). 따라서 하천 수변구역을 대상으로 CNN 계열 모델과 Transformer 기반 모델을 동일한 학습 조건에서 비교하고, 고해상도 다중분광 위성영상의 적용 가능성을 평가할 필요가 있다.
또한 딥러닝 기반 토지피복 분류에서는 학습 라벨의 품질이 모델 성능에 직접적인 영향을 미친다. 하천 수변구역의 경우 현장 실측 기반의 정밀 라벨을 대규모로 구축하기 어렵기 때문에 전지구 토지피복 자료, 기존 토지피복도, 수동 보정 자료 등을 조합한 학습자료 구축이 요구된다. 그러나 공간해상도 불일치, 영상 취득 시점의 차이, 경계부 혼합화소 등으로 인해 라벨 불확실성이 발생할 수 있다. 이에 따라 분광 특성, 공간적 연속성, 형태학적 필터링 등을 고려한 라벨 정제 과정이 필요하며, 이는 하천 수변구역 분류 모델의 신뢰성 향상에 중요한 요소로 작용한다.
본 연구에서는 미호강 수변구역 대상으로 PlanetScope 고해상도 다중분광 위성영상과 딥러닝 기반 의미론적 분할 기법을 활용하여 하천환경 토지피복 분류 모델을 구축하고자 한다. 본 연구의 차별성은 하천 수변구역의 토지피복 특성을 반영한 학습자료 구축 방법에 있다. Dynmic World와 환경부 토지피복도를 클래스별로 선택적으로 결합하고, 토지피복 경계부 화소 제거와 분광지수 기반 마스킹을 적용함으로써 학습 라벨에 포함될 수 있는 불확실성을 완화하고자 하였다. 이를 위해 PlanetScope 8개 밴드와 NDVI, NDWI를 결합한 10채널 입력자료를 구성하고, 공간 블록 분할을 통해 학습·검증·테스트 자료의 공간적 독립성을 확보하였다. 이후 U-Net, Attention U-Net, DeepLabV3+, SegFormer 모델을 동일한 조건에서 학습·평가하여 정제된 라벨의 실제 적용성을 검증하였으며, 최종적으로 최적 모델을 2025년 하천 수위 상승 전후 영상에 적용하여 수체, 나지, 초지 및 목본 식생 등의 면적 변화를 정량화하고, 고해상도 위성영상 기반 하천환경 변화 모니터링의 적용 가능성을 평가하고자 한다.
2. 연구 대상 및 자료
2.1 연구 대상 지역
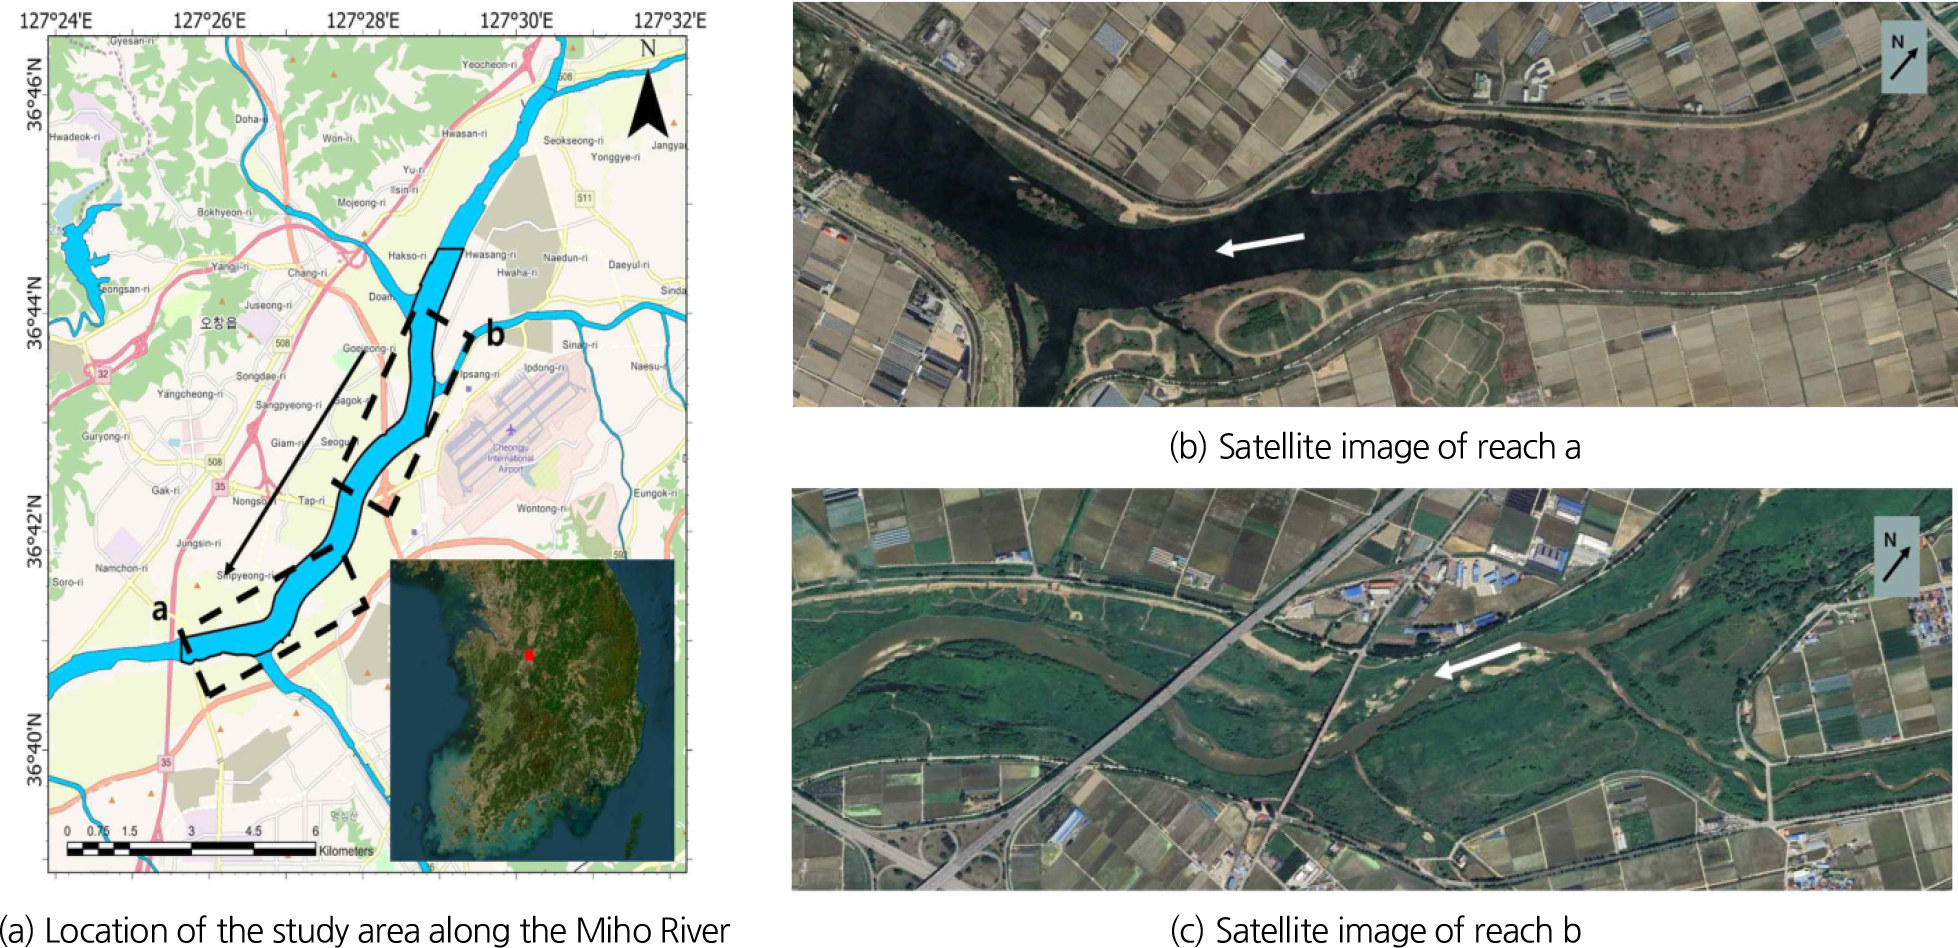
미호강(구 미호천)은 금강 수계의 제1지류로, 충청북도 음성군에서 발원하여 세종특별자치시 인근에서 금강 본류에 합류하는 총 연장 89 km, 유역 면적 1,861 km²의 하천이다(Fig. 1). 미호강 유역은 농경지와 도시지역이 복합적으로 분포하여 강우 시 비점오염의 영향을 받으며(Lee et al., 2026), 다양한 수변식생 군락이 형성되어 있다(Lee et al., 2018). 또한 유량 및 수위 변화에 따른 퇴적과 하도 변화가 나타나는 등 수문·지형학적 변동성을 갖는 하천이다(Shin and Kim, 2025). 본 연구의 분석 구역은 청주시 청원구 외하동 일대의 상류 구역과 흥덕구 문암동 일대의 하류 구역으로 구성되며, 하천 중심선 기준 총 구간 길이는 약 5.87 km, 전체 분석 면적은 265.8 ha이다.
2.2 PlanetScope 위성 영상
2.2.1 위성영상 밴드 및 위성영상 수집
본 연구에서는 미호강 수변환경의 토지피복 분류 및 수위상승 전·후 변화 분석을 위해 PlanetScope SuperDove (PS2.SD) 영상을 수집하였다. PlanetScope는 태양동기궤도(sun-synchronous orbit)를 기반으로 운영되는 CubeSat 군집위성으로, 180기 이상의 소형 위성으로 구성되어 준일별(near-daily) 전지구 육지 관측이 가능하다. 사용 영상은 PlanetScope Level 3B Surface Reflectance 제품으로, 대기보정 및 정사보정이 적용된 지표반사도 자료이다. 해당 영상은 약 3 m의 공간해상도를 가지며, Coastal Blue, Blue, Green I, Green, Yellow, Red, Red-edge, NIR의 8개 다중분광 밴드로 구성된다. 주요 영상 사양은 Table 1에 제시하였다.
Table 1.
Specifications of PlanetScope SuperDove (PS2.SD) imagery
딥러닝 기반 토지피복 분류모델의 학습자료 구축을 위해 2023년과 2024년에 촬영된 총 3개 시기의 영상을 활용하였다. 학습용 영상은 2023년 미호강 하류 영상(2023년 9월 6일), 2023년 미호강 상류 영상(2023년 8월 7일), 2024년 미호강 상류 영상(2024년 8월 29일)으로 구성하였다. 학습영상은 식생 활성이 높은 여름철 및 초가을 영상을 중심으로 선정하였다. 이는 해당 시기에 목본, 초지, 나지 및 수체 간 분광 특성이 비교적 명확하게 구분되며, 하천 수변구역 내 주요 피복 요소의 시각적·분광적 판별이 용이하기 때문이다.
수위 상승 전·후 토지피복 변화 분석을 위해 2025년에 촬영된 2개 시기의 영상을 추가로 수집하였다. 수위 상승 전 영상은 2025년 8월 10일, 수위 상승 후 영상은 2025년 9월 5일 자료를 활용하였다. 두 영상 사이의 기간인 2025년 8월 26일 미호강 유역에 강우 사상이 발생하였다. 금강홍수통제소가 운영하는 청주시(미호강교) 수위관측소 실측 자료에 따르면, 해당일 오전 수위가 1.44 m에서 11시경 3.37 m까지 약 1.93 m 급상승하였으며, 이는 관측 기간(8월 11일~9월 5일) 중 가장 뚜렷한 수위 변동이었다. 이를 기준으로 수위상승 전·후의 토지피복 변화를 비교하였다.
2.3 학습 라벨 생성
2.3.1 라벨 소스 및 클래스 정의
수변환경의 특성을 반영하여 토지피복을 수체(water body), 초지(grassland), 목본(woody vegetation), 나지(bare soil), 도로(road)의 5개 클래스로 정의하였다. 각 클래스의 라벨 생성 기준 자료는 클래스 특성에 따라 달리 적용하였다. 초지·목본·나지는 시간해상도 측면에서 PlanetScope 영상 취득 시기와의 정합성이 우수한 Google Dynamic World v1(공간해상도 10 m)을 활용하였다. 반면 수체와 도로는 환경부 중분류 토지피복도를 활용하였다. 수체는 수계 경계의 공간적 정밀도가 높고, 도로는 시계열 변화가 없어 안정적이며 선형 객체 경계의 정확도가 우수하여 해당 자료가 적합한 기준으로 판단되었다. 이와 같이 클래스 특성에 따라 기준 자료를 달리함으로써 학습 라벨의 공간적 정확도와 시간적 정합성을 동시에 확보하고자 하였다.
2.3.2 분광지수 기반 학습 라벨 정제
10 m 해상도의 Dynamic World 라벨을 3 m PlanetScope 해상도로 리샘플링할 경우 토지피복 경계부에서 혼합화소 및 라벨 불확실성이 증가할 수 있다. 이를 보완하기 위해 혼합 경계부 화소 제거와 분광지수 기반 마스킹을 순차적으로 적용하여 토지피복 경계 및 분광 특성의 불확실성이 높은 화소를 학습에서 제외하였다. 먼저, 각 클래스 마스크에 이진 침식(binary erosion)을 적용하여 경계부 픽셀을 학습 제외 화소(ignore, 255)로 처리하였으며, 침식 크기는 초지·목본·나지 클래스에 대해 2픽셀, 수체·도로 클래스에 대해 1픽셀로 클래스 특성에 따라 차등 적용하였다. 다음으로, 분광지수(NDVI, NDWI)를 이용하여 클래스 특성에 부합하지 않는 이상치 픽셀을 추가로 제거하였다. 적용 기준은 수체 NDWI < -0.60, 목본 NDVI < 0.45, 초지 NDVI < 0.15 또는 NDVI > 0.80, 나지 NDVI > 0.92, 도로 NDVI > 0.55로 설정하였다. 이 두 정제 과정을 통해 각 피복 별 유효 픽셀의 17.0%가 추가로 학습에서 제외되었다.
3. 연구 방법
3.1 패치 생성 및 데이터셋 분할
전처리된 영상에서 512 × 512픽셀 크기의 패치를 256 픽셀 이동간격으로 추출하여 총 2,507개의 패치를 생성하였다(Fig. 2). 공간 자기상관(spatial autocorrelation)에 의한 학습-검증 간 정보 유출을 방지하기 위해 공간 블록 분할(spatial block split) 방식을 적용하였으며, 영상을 격자형 공간 블록으로 구획한 후 블록 단위로 훈련(74.4%, 1,865장), 검증(13.7%, 343장), 테스트(11.9%, 299장) 세트로 배분하였다. 이를 통해 인접 패치 간 공간적 유사성이 검증 성능을 과대 추정하는 문제를 방지하였다. 최종 학습 입력은 PlanetScope 8개 밴드 반사율(DN/10,000 정규화)에 분광지수 NDVI와 NDWI를 추가한 총 10채널로 구성하였으며, 각 지수는 Eqs. (1) and (2)와 같이 산정하였다.
여기서 B4는 Green (565 nm), B6는 Red (665 nm), B8은 NIR (865 nm) 밴드이다.
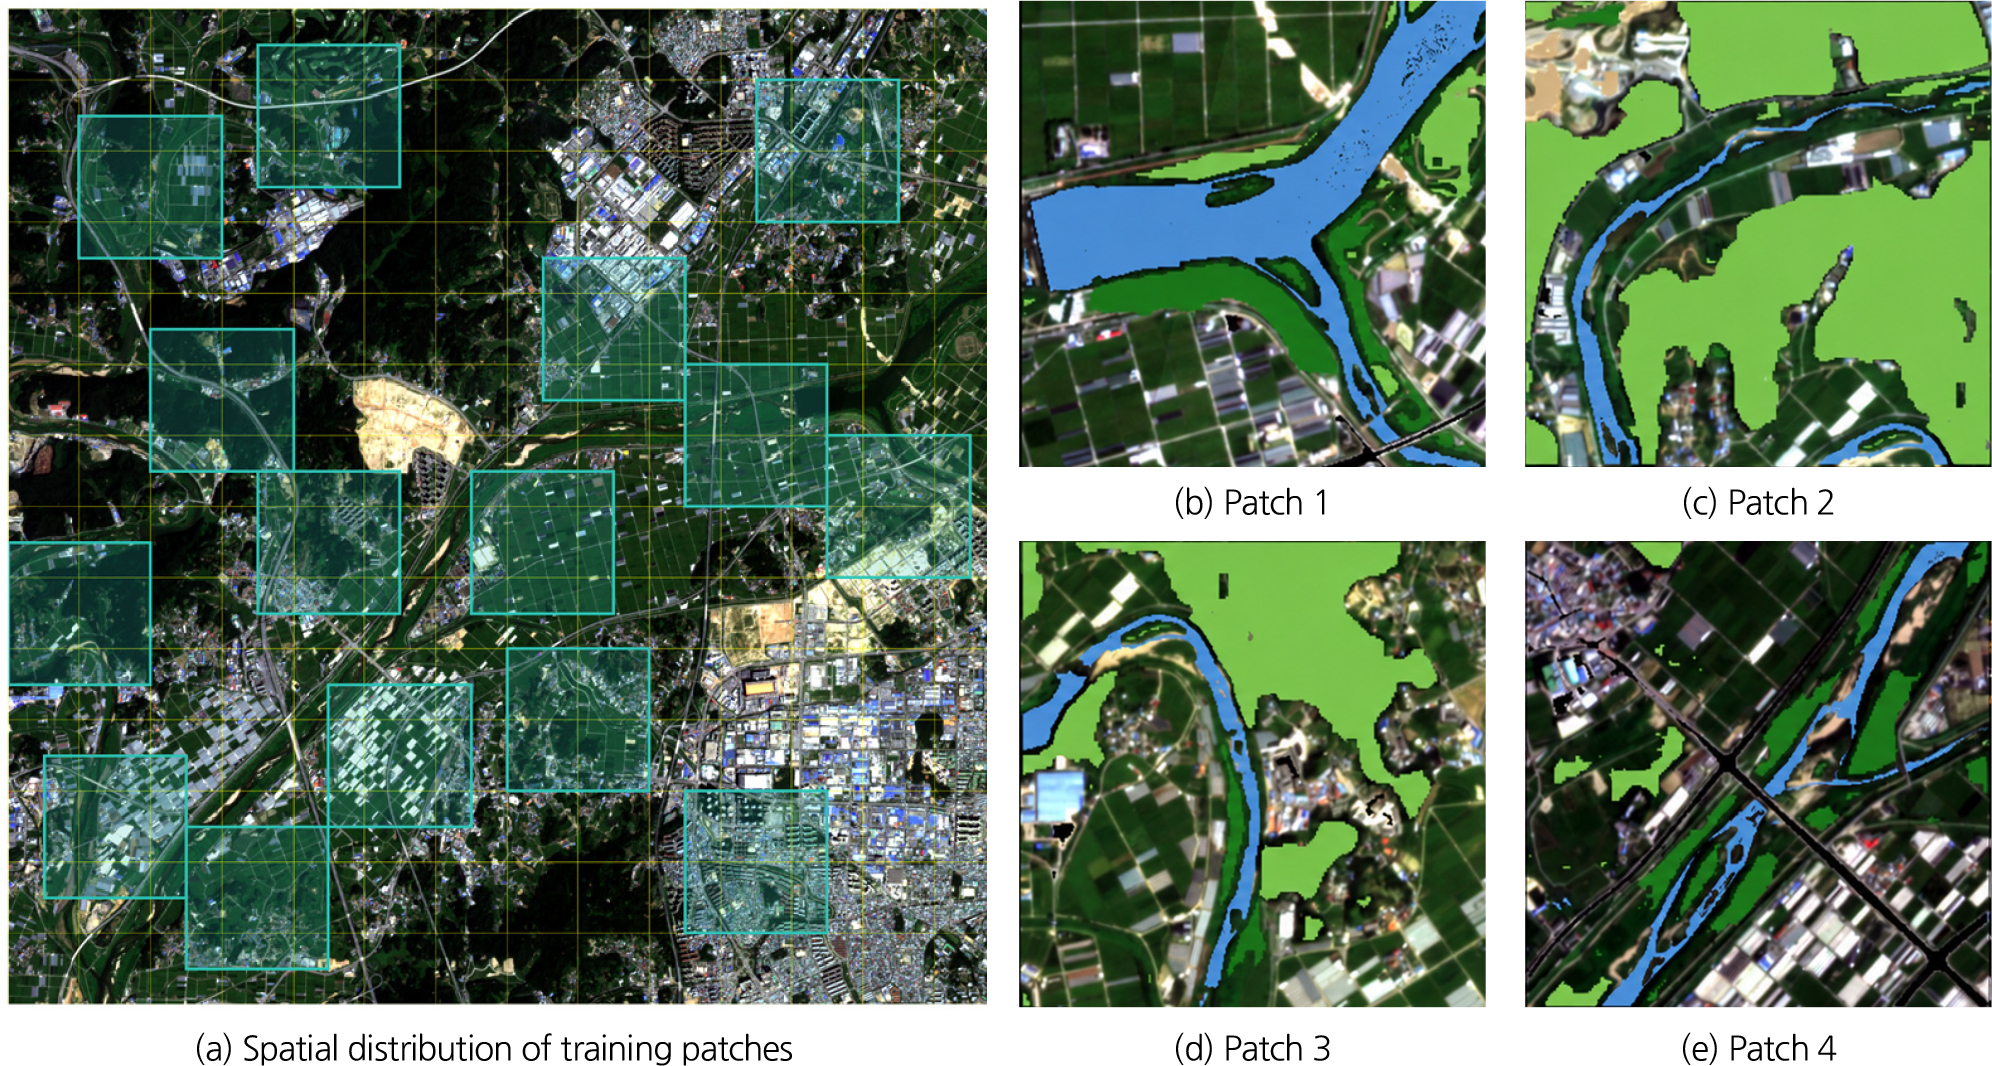
Fig. 2.
raining patch extraction using a sliding window (patch size: 512 × 512 pixels; stride: 256 pixels) and examples of preprocessed image–label pairs. (a) Spatial distribution of training patches over the study area (b)–(e) Representative patches with label masks overlaid on the preprocessed satellite imagery
3.2 딥러닝 모델
본 연구에서는 PlanetScope 위성영상 기반 하천 토지피복 분류를 위해 U-Net, Attention U-Net, DeepLabV3+ 및 SegFormer의 4개 의미론적 분할 모델을 비교하였다. 각 모델은 인코더-디코더 기반 구조 또는 Transformer 기반 구조를 가지며, 동일한 학습자료와 입력 조건에서 성능을 평가하였다.
3.2.1 U-Net
U-Net은 인코더-디코더 구조와 스킵 연결(skip connection)을 기반으로 하는 대표적인 의미론적 분할 모델이다(Ronneberger et al., 2015). 인코더는 입력 영상으로부터 고차원 특징을 추출하고, 디코더는 단계적으로 공간해상도를 복원하여 픽셀 단위 분류 결과를 생성한다. 스킵 연결은 인코더의 저수준 공간 정보를 디코더로 전달함으로써 경계부 및 소규모 객체의 분할 성능을 향상시키는 역할을 한다. 본 연구에서는 EfficientNet-B4(Tan and Le, 2019)를 인코더 백본으로 사용하였다.
3.2.2 Attention U-Net
Attention U-Net은 attention gate를 통해 분류에 유용한 공간 특징을 선택적으로 강조하는 구조이다(Oktay et al., 2018). 본 연구에서는 Concurrent Spatial and Channel Squeeze-and-Excitation (scSE) 블록을 추가로 적용하여 공간 및 채널 방향의 특징 응답을 보정하였다(Roy et al., 2018). 이를 통해 수체, 식생, 나지 및 도로와 같이 분광·공간적 특성이 상이한 피복 요소에 대한 특징 표현을 강화하고자 하였다. 인코더 백본은 U-Net과 동일하게 EfficientNet-B4를 사용하였다.
3.2.3 DeepLabV3+
DeepLabV3+는 Atrous Spatial Pyramid Pooling (ASPP)을 이용하여 다양한 수용영역의 특징을 병렬적으로 추출하고, 인코더-디코더 구조를 통해 공간 정보를 복원하는 의미론적 분할 모델이다(Chen et al., 2018). ASPP는 서로 다른 dilation rate를 갖는 atrous convolution을 적용하여 다중 스케일 맥락 정보를 반영할 수 있다. 본 연구에서는 하천 내 피복 요소의 크기와 형태가 다양하게 나타나는 특성을 고려하여 DeepLabV3+를 비교 모델로 선정하였으며, EfficientNet-B5를 인코더 백본으로 사용하였다.
3.2.4 SegFormer (MiT-B4 + FPN)
SegFormer는 Mix Transformer (MiT) 인코더와 경량 디코더를 결합한 Transformer 기반 의미론적 분할 모델이다(Xie et al., 2021). MiT 인코더는 계층적 특징 표현을 생성하여 다양한 공간 스케일의 정보를 반영할 수 있으며, 이는 수체, 식생, 나지 및 도로가 혼재하는 하천구역의 복잡한 피복 분류에 적합하다. 본 연구에서는 MiT-B4 인코더와 Feature Pyramid Network (FPN; Lin et al., 2017) 디코더를 결합하여 다중 스케일 특징을 융합하였다.
모든 모델은 PlanetScope 8개 반사율 밴드와 NDVI, NDWI를 포함한 10채널 입력자료를 사용하도록 입력층을 수정하였다. ImageNet (Deng et al., 2009) 사전학습 가중치를 활용하였으며, 기존 RGB 입력 가중치는 채널 평균 복사 방식으로 확장하여 10채널 입력에 대응하도록 초기화하였다.
Table 2에 제시한 바와 같이4개 모델의 파라미터 수와 연산량에는 상당한 차이가 있다. U-Net과Attention U-Net은 동일한EfficientNet-B4 백본을 사용하여 규모가 유사하며, DeepLabV3+는 한 단계 큰 EfficientNet-B5를 사용해 파라미터 수가 다소 증가하였다. SegFormer는Transformer 기반 MiT-B4 인코더를 사용하여 파라미터 수(62.75Mil.)와 연산량(62.39 GFLOPs)이 다른 세 모델 대비 약2~3배 크며, 이러한 모델 용량의 차이는 이후 성능 비교 결과를 해석하는 데 함께 고려되어야 한다.
Table 2.
Computational characteristics of the four semantic segmentation models
| Model |
Encoder /Backbone | Parameters (M) |
GFLOPs (512 × 512) |
| U-Net | EfficientNet-B4 | 20.23 | 19.03 |
| Attention U-Net (scSE) | EfficientNet-B4 | 20.31 | 19.07 |
| DeepLabV3+ | EfficientNet-B5 | 29.50 | 28.35 |
| SegFormer | MiT-B4 | 62.75 | 62.39 |
3.3 모델 학습 조건 및 최적화 전략
본 연구에서는 모델 구조에 따른 성능 차이를 비교하기 위해 모든 의미론적 분할 모델에 동일한 학습 조건을 적용하였다. 손실 함수는 클래스 불균형과 경계부 분류 오차를 함께 고려하기 위해 Cross-Entropy Loss와 Tversky Loss를 1:1 비율로 결합한 Combined Loss를 사용하였다. Cross-Entropy Loss에는 과신뢰(overconfidence) 억제를 위해 라벨 스무딩(label smoothing) 계수 0.05를 적용하였으며, Tversky Loss의 위양성 및 위음성 가중 계수는 각각 α = 0.7, β = 0.3으로 설정하였다.
최적화 알고리즘은 AdamW를 사용하였으며, weight decay는 0.01로 설정하였다. 사전학습 인코더와 분할 디코더의 학습 안정성을 고려하여 차등 학습률을 적용하였으며, 인코더 학습률은 5 × 10⁻⁵, 디코더 학습률은 5 × 10⁻⁴로 설정하였다. 학습률 스케줄러는 CosineAnnealingWarmRestarts를 적용하였고, 초기 주기는 T₀ = 15 epoch로 설정하였다. 학습 데이터의 공간적 다양성을 확보하고 과적합을 완화하기 위해 수평·수직 반전, 무작위 90° 회전, 밝기·대비 조정, 가우시안 노이즈 추가의 자료 증강을 적용하였다.
모든 모델은 총 60 epoch 동안 학습하였으며, 배치 크기는 8로 설정하였다. 검증 세트 mIoU가 최대인 epoch의 가중치를 최종 모델로 저장하여 테스트셋 평가에 활용하였다. 학습은 NVIDIA RTX 4090 GPU 환경에서 수행하였으며, 재현성 확보를 위해 무작위 시드는 42로 고정하였다(Table 3).
Table 3.
Training configuration and hyperparameters
3.4 평가 지표
모델 성능 평가를 위해 클래스별 IoU (Intersection over Union), Precision, Recall, F1 Score와 함께 전체 정확도(Overall Accuracy, OA), 평균 IoU (mIoU), 평균 F1(mF1)을 산출하였다. 모든 지표 산정 시 학습 제외 화소(ignore, 255)는 평가에서 제외하였다. OA는 전체 유효 픽셀 중 정확히 분류된 픽셀의 비율로 Eq. (3)과 같이 정의된다.
클래스별 IoU는 예측 영역과 실제 영역의 교집합을 합집합으로 나눈 값으로 Eq. (4)와 같다.
F1 Score는 정밀도(Precision)와 재현율(Recall)을 조화평균한 값을 의미한다. 정밀도와 재현율은 각각 Eqs. (5) and (6)를 통해 계산하며, F1 Score의 값이 1에 근접할수록 정확도가 높은 것을 의미한다.
TP_c, FP_c, FN_c는 각각 클래스 c에 대한 진양성, 위양성, 위음성 픽셀 수이며, N은 전체 유효 픽셀 수이다
4. 결 과
4.1 모델별 분류 성능 비교
4개 딥러닝 모델을 동일 조건(refined label, 동일 하이퍼파라미터, 동일 학습 데이터)으로 학습한 테스트셋(n = 299) 기반 성능 비교 결과를 Table 4에 제시하였다.
Table 4.
Test set performance comparison of deep learning models (spatial block split, n = 299)
SegFormer (MiT-B4+FPN)가 OA 96.82%, mIoU 0.8275, mF1 0.8954로 4개 모델 중 최고 mIoU를 기록하였다. Att-U-Net (mIoU 0.7965)이 두 번째, U-Net (0.7691)이 세 번째였으며, DeepLabV3+(0.7251)이 가장 낮은 성능을 보였다. 단, 클래스별로는 수체(U-Net 0.939 > SegFormer 0.934), 나지(U-Net 0.570 > 0.537), 목본(U-Net 0.973 > 0.965)에서 U-Net이 소폭 우세하였으며, SegFormer는 도로(0.735)와 초지(0.966)에서 두드러진 우위를 보였다. SegFormer의 전체 mIoU 우위는 특히 도로 클래스에서의 압도적 성능 (SegFormer 0.735 vs. U-Net 0.458)에 기인한다. 다만 SegFormer는 다른 세 모델보다 약 2~3배 큰 파라미터 수와 연산량을 가지므로, 이러한 성능 차이가 Mix Transformer의 자기주의 메커니즘 자체의 효과인지 모델 용량 증가에 따른 효과인지는 본 연구의 실험 설계만으로는 명확히 구분하기 어렵다.
4.2 분광지수 기반 학습 라벨 정제 후 결과 비교
라벨 정제 과정의 효과를 정량적으로 검증하기 위해 SegFormer를 대상으로 원본 라벨, 토지피복 경계부 화소만 제외한 라벨, 분광지수 기반 마스킹만 적용한 라벨, 그리고 두 정제 절차를 모두 적용한 최종 라벨의 네 가지 조건에서 동일한 학습 설정으로 ablation study를 수행하였다(Table 5).
Table 5.
Ablation study of the training-label refinement procedure (validation set)
원본 라벨을 적용한 경우 검증자료의 mIoU는 0.7873으로 나타났으며, 분광지수 기반 마스킹만 적용한 경우 0.7996으로 소폭 향상되었다. 토지피복 경계부 화소만 제외한 경우에는 mIoU가 0.8297로 증가하였으며, 경계부 화소 제외와 분광지수 기반 마스킹을 모두 적용한 최종 라벨에서는 0.8366으로 가장 높은 성능을 나타내어 원본 라벨 대비 0.0493(4.93%p) 향상되었다. 특히 도로 클래스의 IoU는 원본 라벨에서 0.683이었으나, 경계부 화소 제외만 적용한 경우 0.727, 두 정제 절차를 모두 적용한 경우 0.773으로 향상되었다. 이는 폭이 좁고 선형적인 도로 클래스가 공간해상도 차이에 따른 경계부 라벨 불확실성의 영향을 상대적으로 크게 받을 수 있음을 보여준다. 이러한 결과를 통해 토지피복 경계부 화소 제외와 분광지수 기반 마스킹을 적용한 학습 라벨 정제가 모델의 분류 성능 향상에 기여함을 확인하였다.
토지피복 경계부 제외 범위와 NDVI·NDWI 임계값은 실제 학습자료 200개 패치에서 추출한 클래스별 분광 분포를 사전 분석하여 설정하였다. 수체 클래스의 NDWI는 5~95 백분위 범위에서 -0.68~-0.08로 나타났으며, 본 연구대상지에서는 일반적으로 수체에서 기대되는 양의 NDWI 값과 상이한 분포가 확인되었다. 따라서 절대적인 양의 NDWI 기준을 적용하기보다 학습자료에서 확인된 수체 클래스의 상대적 분포를 고려하여 NDWI < -0.60인 화소를 라벨 불확실성이 높은 화소로 간주하고 학습에서 제외하였다. 나지 클래스의 NDVI 중앙값은 0.780이었으며, 5~95 백분위 범위는 0.49~0.89로 나타났다. 이는 일반적인 나지의 분광 특성과 비교하여 높은 NDVI 분포로, 10 m Dynamic World 라벨을 3 m PlanetScope 영상에 적용하는 과정에서 식생 화소가 일부 포함되었을 가능성을 나타낸다. 이에 전체 분포에서 상위 극단값에 해당하는 NDVI > 0.92인 화소만을 라벨 불확실성이 높은 화소로 판단하여 제외하였다.
토지피복 경계부 화소는 각 클래스 마스크에 이진 침식(binary erosion)을 적용하여 제거하였다. 초지, 목본 및 나지 클래스는 경계부에서 2픽셀을 제외하였으며, 상대적으로 폭이 좁거나 선형적인 형태를 갖는 수체 및 도로 클래스는 과도한 경계부 제거에 따른 객체 소실을 최소화하기 위해 1픽셀을 제외하였다. 이러한 경계부 제외 범위와 분광지수 임계값은 본 연구대상지의 학습자료에서 확인된 공간적·분광적 특성을 바탕으로 설정한 경험적 기준이며, 별도의 정량적 민감도 분석은 수행하지 않았다. 따라서 다른 하천이나 계절적 조건에 적용할 경우 해당 지역의 분광 분포와 토지피복 특성을 고려한 추가적인 검증이 필요하다.
4.3 최적 모델(SegFormer) 클래스별 성능
수체(IoU 0.934), 초지(0.966), 목본(0.965)은 매우 높은 분류 정확도를 나타냈다(Table 6). 나지(IoU 0.537)와 도로(0.735)는 상대적으로 낮은 성능을 보였는데, 나지는 수변 모래톱·자갈밭의 식생 혼입으로 분광 반응이 동적으로 변화하며 Dynamic World 10 m 라벨의 불확실성이 높은 클래스이다. 도로의 Recall (0.973)이 높게 유지되어 모델이 도로 픽셀 대부분을 탐지하고 있음을 의미하며, 낮은 Precision (0.751)은 도로 인접 나지·초지를 도로로 오분류하는 경향을 반영한다.
Table 6.
Class-wise test set performance of SegFormer (MiT-B4 + FPN)
4.4 모델 간 클래스별 성능 비교
목본(IoU: U-Net 0.973, Att-U-Net 0.970, SegFormer 0.965, DeepLabV3+ 0.964)과 초지(SegFormer 0.966, Att-U-Net 0.912, U-Net 0.905, DeepLabV3+ 0.882)는 전 모델이 안정적인 분류 성능을 보인다. 도로 클래스에서 모델 간 성능 격차가 가장 크게 나타났는데, SegFormer (0.735) 대비 DeepLabV3+(0.354)는 절반 이하의 IoU를 보였다. 수체 분류에서는 U-Net (0.939)이 SegFormer (0.934)보다 소폭 높은 IoU를 기록하였으며, 이는 NDWI 기반으로 분광 특성이 명확하여 CNN 계열 모델도 충분한 성능을 발휘할 수 있음을 시사한다. 나지 분류는 전 모델에서 IoU 0.516~0.570 수준의 구조적 한계를 보인다(Table 7).
Table 7.
Class-wise IoU comparison of deep learning models
4.5 수위 상승 전후 토지피복 분류 결과
4.5.1 수위 상승 전후 토지피복 지도 비교
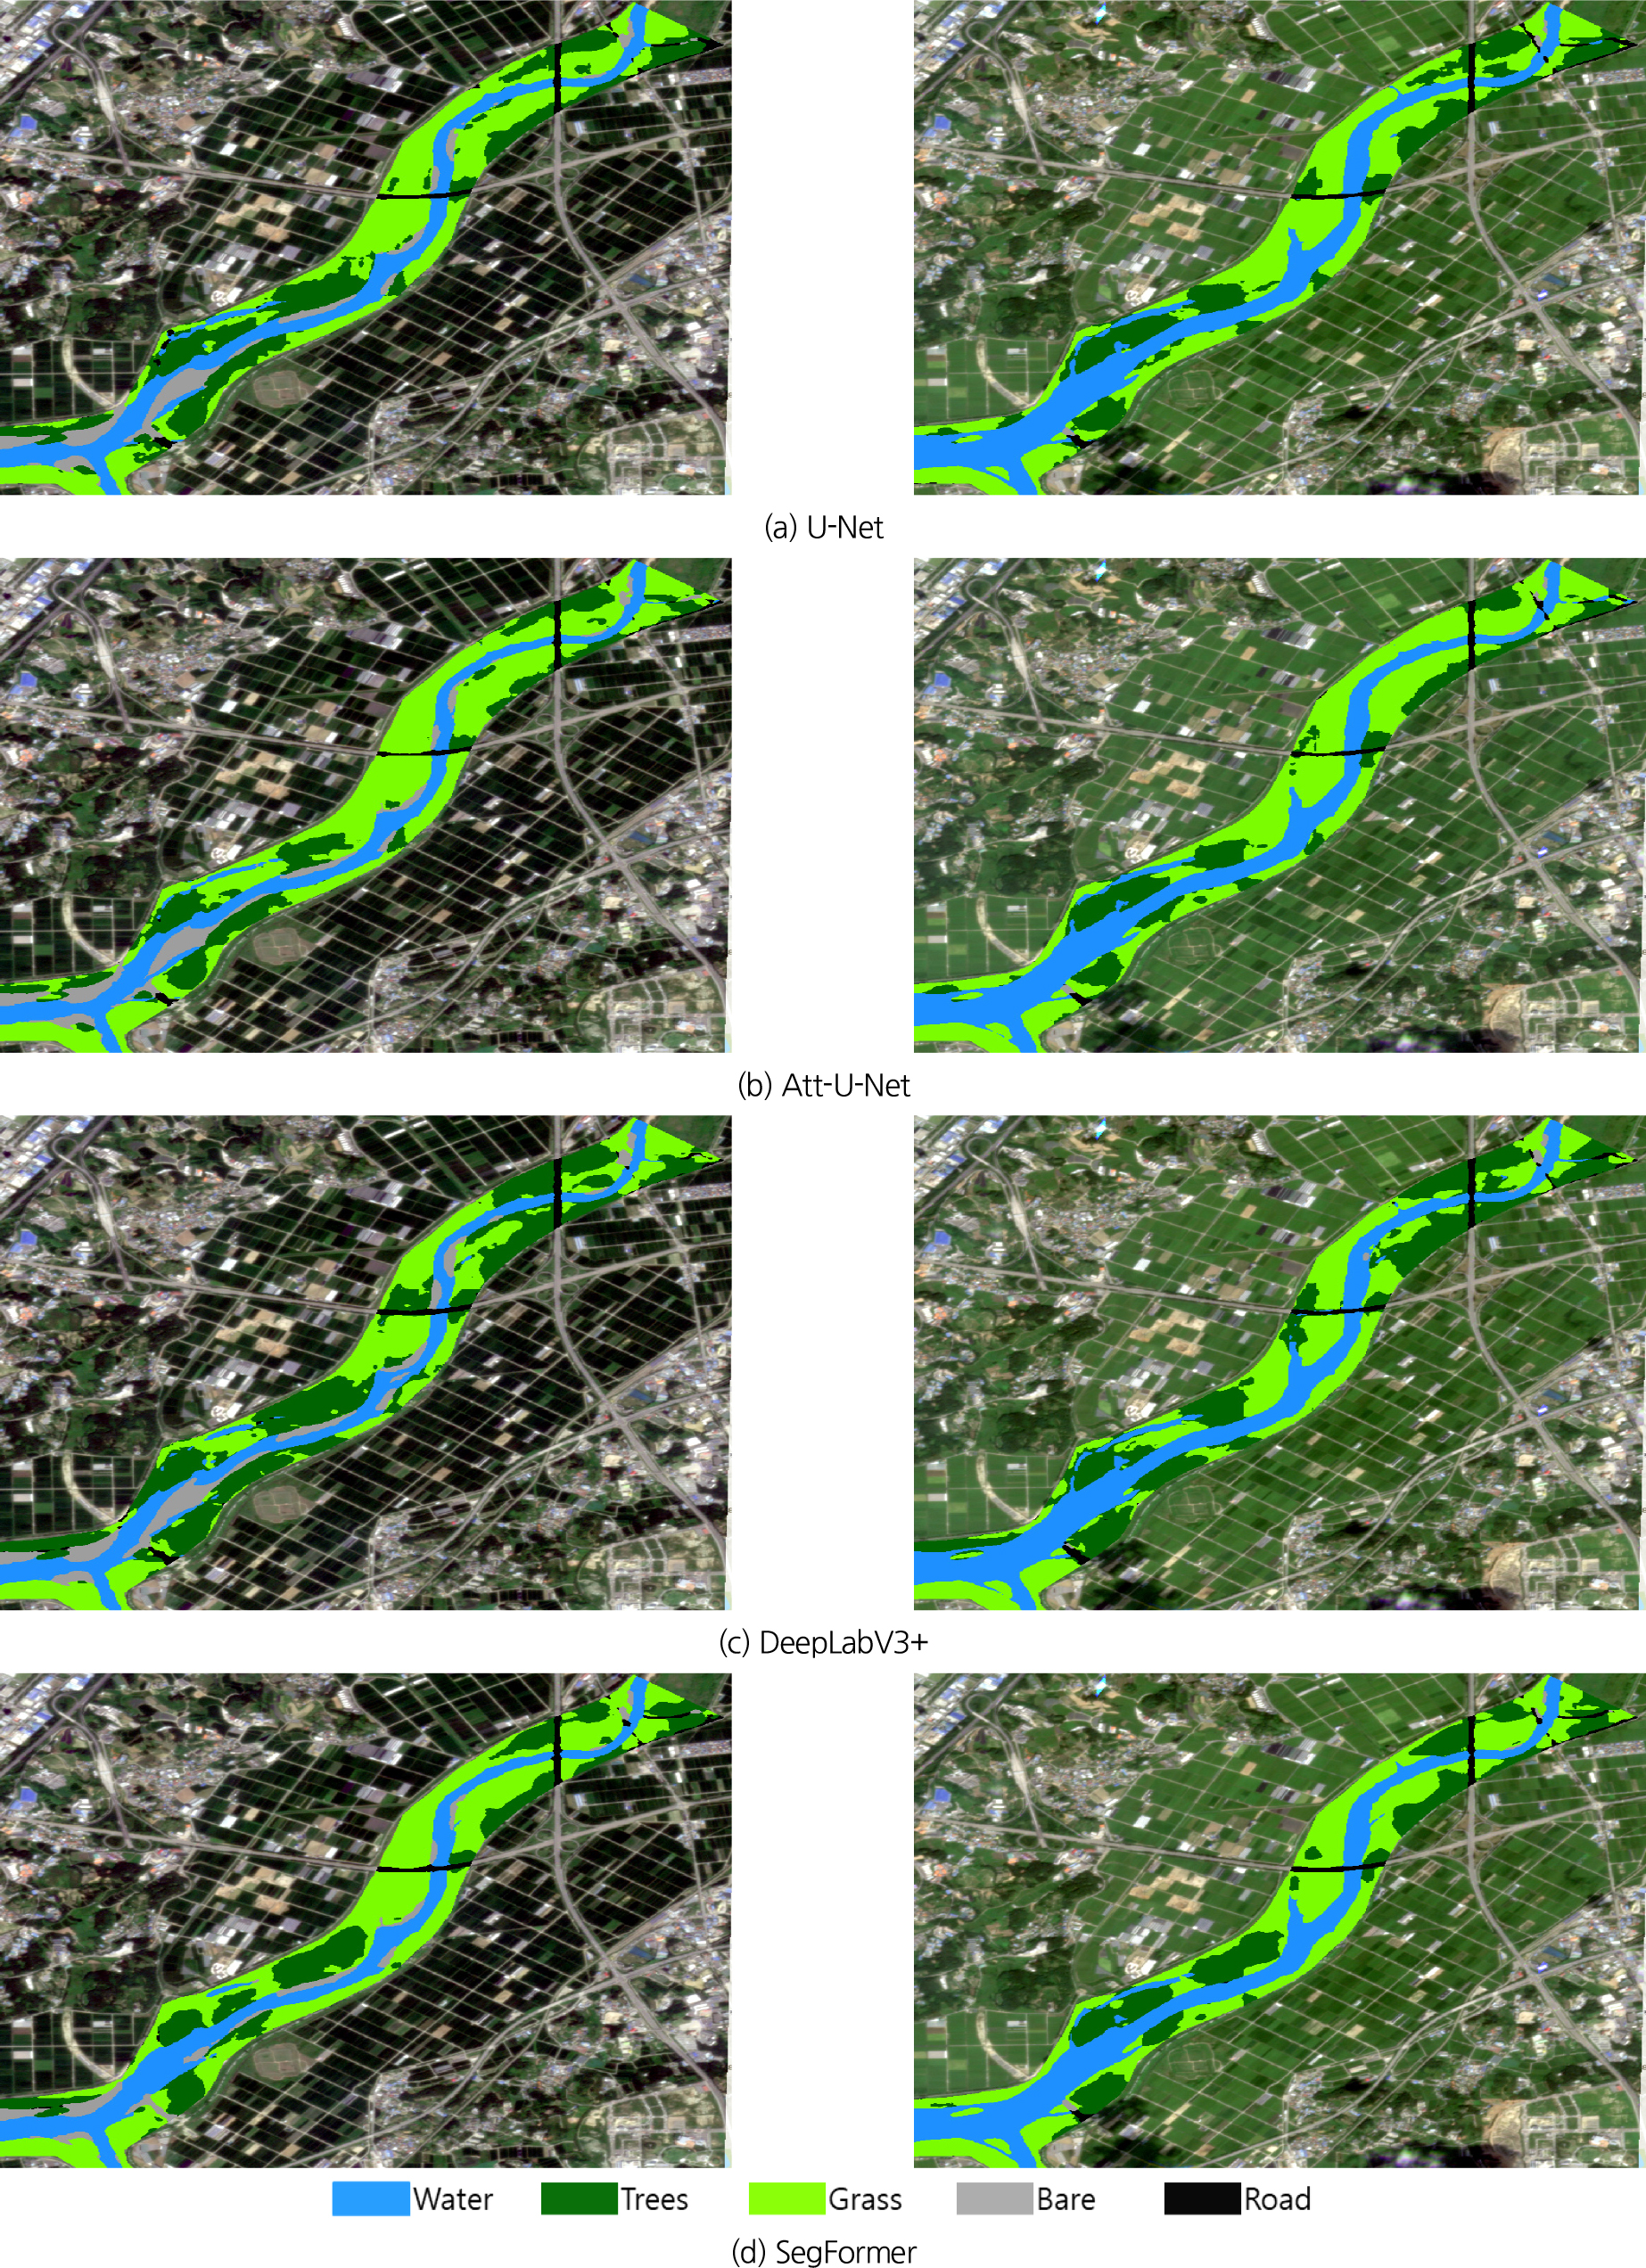
최적 모델(SegFormer)을 2025-08-10(수위상승 전)과 2025-09-05(수위상승 후) 전체 영상에 512 × 512 픽셀, 300 픽셀 이동 간격의 슬라이딩 윈도우를 적용하여 토지피복 분류 지도를 생성하였다. 클래스별 면적(ha, %)을 산출하고 수위 상승 전·후의 면적 변화량과 변화율을 비교하여 토지피복 변화의 규모를 정량화 하였다. 또한 4개 딥러닝 모델의 하천 수위 상승 전후 분류 결과를 시각적으로 비교하여 모델 간 차이를 분석하였다.
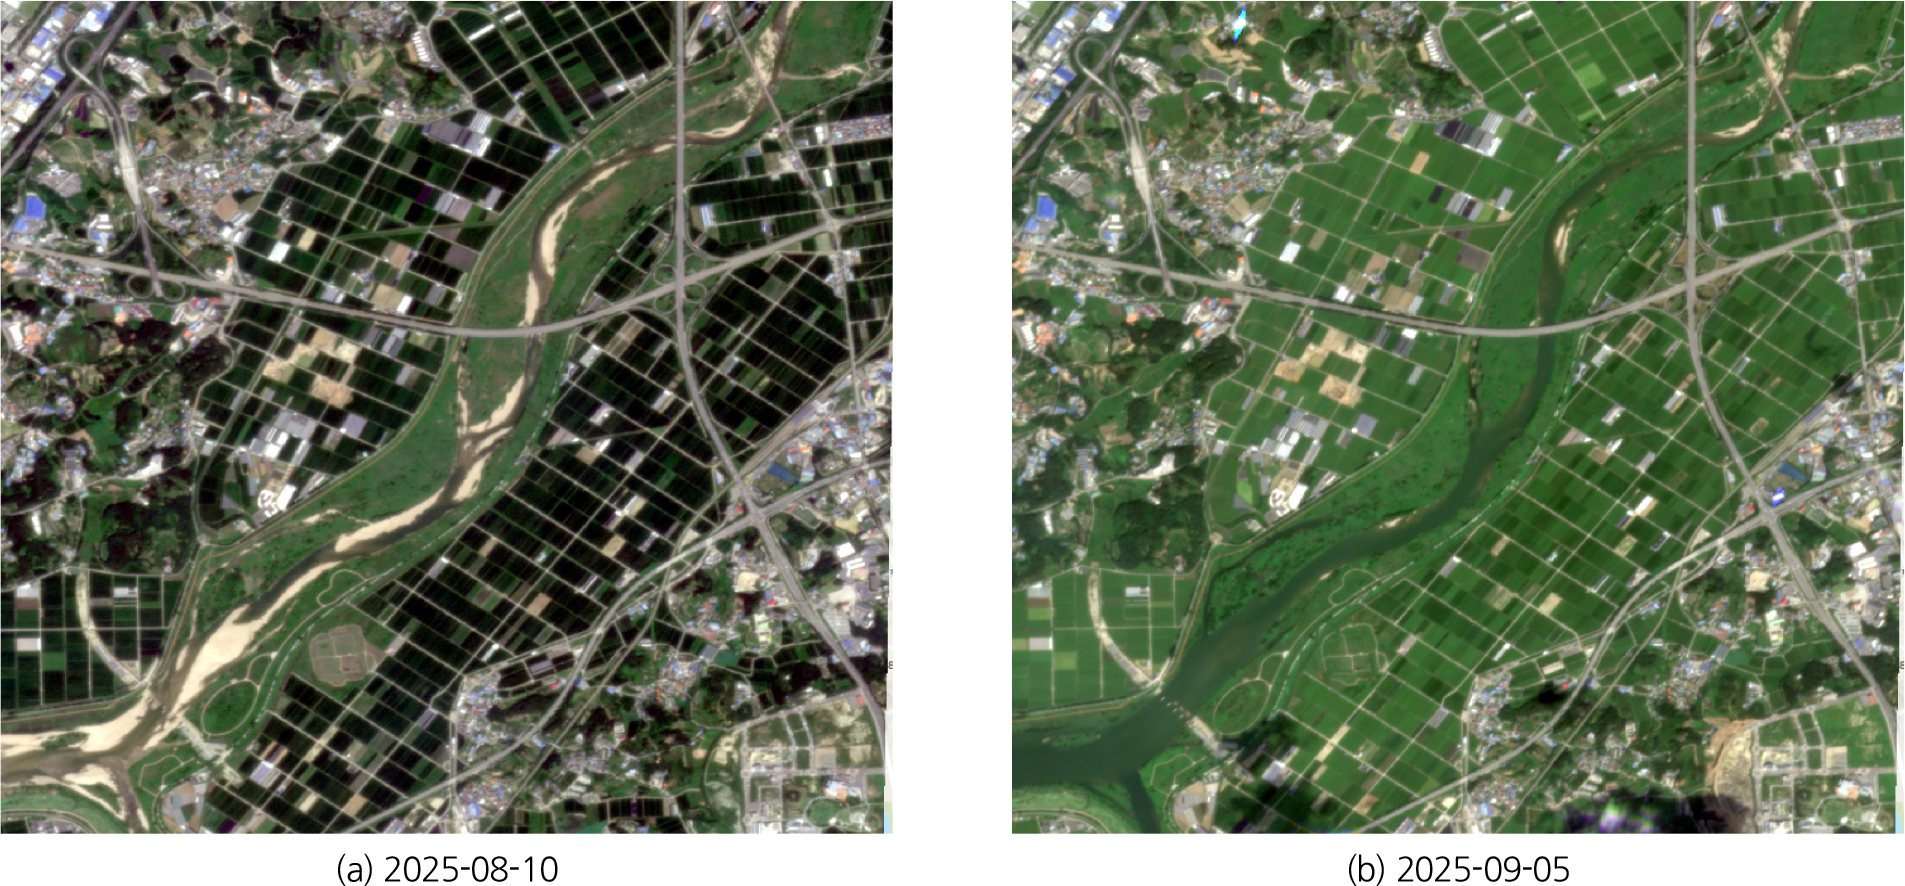
수위 상승 전후의 PlanetScope 원본 영상을 Fig. 3에 나타내었으며, 수위상승 후 영상에서 수체 경계가 하천 중류부 일부 구간에서 확장된 것이 시각적으로 확인된다. 4개 딥러닝 모델의 분류 결과 비교(Fig. 4)에서는 전 모델에서 수체 및 수변 식생의 공간 분포가 유사하게 나타났으나, 도로 및 제방 구간에서 모델 간 차이가 뚜렷하였다. SegFormer는 하천 경계부의 선형 구조를 보다 연속적으로 탐지한 반면, DeepLabV3+ 및 U-Net 계열 모델은 도로·나지 경계에서 분류 파편화 경향이 관찰되었다.
4.5.2 수위 상승 전후 면적 변화
수위 상승 이후 가장 주목할 변화는 수체 면적이 60.0 ha에서 96.2 ha로 60.3%(+36.2 ha) 증가하고, 나지(모래톱·자갈밭)가 25.6 ha에서 0.9 ha로 96.5%(-24.7 ha) 감소한 것이다. 목본은 62.5 ha에서 83.4 ha로 33.4% 증가하였고, 초지는 110.0 ha에서 78.9 ha로 28.3% 감소하였다(Table 8). 각 클래스 변화에 대한 해석과 불확실성은 5.2절에서 논의한다.
Table 8.
Land cover area changes before and after the rainfall-related water-level rise
5. 고 찰
5.1 모델성능 및 학습 라벨품질에 대한 고찰
본 연구에서는 PlanetScope 고해상도 다중분광영상과 딥러닝 기반 의미론적 분할 모델을 활용하여 미호강 수변환경의 토지피복을 분류하고, 수위 상승 전후의 피복 변화를 정량적으로 분석하였다. 분석 결과, SegFormer 모델은 전체 정확도(OA) 96.82%, mIoU 0.8275, mF1 0.8954로 비교 모델 중 가장 높은 mIoU를 나타냈다. SegFormer는 본 연구의 자료와 학습조건에서 가장 높은 종합 성능을 나타냈다. 다만 비교 모델 간 인코더 백본의 파라미터 수와 연산량이 상이하므로(Table 2), 이러한 성능 차이를 Transformer 구조 자체의 효과로만 해석하기에는 한계가 있으며, 본 연구의 결과는 각 모델의 전체 구성에 따른 적용성 평가로 해석하는 것이 타당하다.
특히 도로 클래스에서 SegFormer의 IoU가 0.735로 나타나 DeepLabV3+ 및 U-Net 계열 모델보다 높은 성능을 보였다. 도로 및 제방과 같은 선형 객체는 주변 나지 또는 식생과 분광 특성이 일부 유사하고 폭이 좁아 혼합화소의 영향을 크게 받는다. 이러한 조건에서 SegFormer의 전역 자기주의(self-attention) 기반 특징 추출 구조와 상대적으로 큰 모델 용량이 함께 작용하여 도로 클래스의 연속성과 주변 문맥 정보를 반영하는 데 기여하였을 가능성이 있다. 다만 백본 규모의 차이를 통제한 실험이 수행되지 않았으므로, 이러한 성능 향상을 자기주의 메커니즘만의 효과로 단정하기는 어렵다. 반면 수체·나지·목본 클래스에서는 U-Net이 일부 지표에서 소폭 우세하게 나타나, 클래스별 공간 특성에 따라 모델 구조별 장점이 상이하게 작용할 수 있음을 확인하였다.
Dynamic World와 환경부 토지피복도를 결합하여 구축한 학습 라벨에 경계부 화소 제외 및 분광지수 기반 마스킹을 적용한 결과, 학습 라벨의 불확실성을 완화하는 데 기여한 것으로 판단된다. Dynamic World 및 환경부 토지피복도와 같은 기존 자료는 광역적 피복 정보를 제공할 수 있으나, PlanetScope 영상과 공간해상도 및 취득 시점이 완전히 일치하지 않는다. 특히 하천 수변구역은 수체 경계, 모래톱, 식생 경계가 단기간에도 변화할 수 있어 경계부 라벨 오류가 발생하기 쉽다. 본 연구에서 적용한 경계부 화소 제외 및 분광지수 기반 라벨 정제는 이러한 경계부 혼합화소와 분광적으로 불일치하는 화소를 제거함으로써 학습자료의 품질을 효과적으로 개선한 것으로 해석된다. 특히 폭이 좁은 도로와 소규모 나지는 10 m 해상도의 Dynamic World 자료에서 인접 클래스와 혼합될 가능성이 크며, 이러한 라벨 불확실성은 나지와 도로 클래스의 상대적으로 낮은 분류 성능에 영향을 미쳤을 것으로 판단된다. 경계부 화소 제외를 위해 적용한 이진 침식(binary erosion)은 불확실한 경계 화소의 영향을 감소시키는 방법으로, 공간해상도와 자료 취득 시점의 차이에서 발생하는 모든 라벨 불확실성을 제거할 수는 없다.
5.2 수위 상승 전후 토지피복 변화의 해석과 불확실성
수위 상승 전후 변화 분석에서는 수체 면적의 뚜렷한 증가(+36.2 ha, 60.3%)와 나지 면적의 급격한 감소(-24.7 ha, 96.5%)가 확인되었다. 금강홍수통제소가 운영하는 청주시(미호강교) 수위관측소의 실측 자료에 따르면, 2025년 8월 26일 오전 수위가 1.44 m에서 11시경 3.37 m까지 약 1.93 m 급상승하였으며, 이는 관측 기간(8월 11일~9월 5일) 중 가장 뚜렷한 수위 변동으로 확인되었다. 이 시점은 수위 상승 전(8월 10일)과 수위 상승 후(9월 5일) 영상 취득 사이에 위치하여, 수체 면적 증가와 나지 감소가 실제 하천 유량 증가 및 일시적 침수와 시간적으로 부합함을 뒷받침한다. 반면, 목본 증가(+33.4%)와 초지 감소(-28.3%)는 수위 상승만으로 설명하는 데 한계가 있다. 두 영상의 취득 시점 차이에 따른 식생의 생육상태 변화와 대기조건, 지표면 수분상태 등 영상 취득조건의 차이가 분광반사 특성에 영향을 미쳤을 가능성이 있으며, 특히 분광 특성이 유사한 목본과 초지 피복 간 분류 결과에 이러한 영향이 반영되었을 가능성을 배제하기 어렵다. 따라서 목본과 초지의 면적 변화는 실제 식생 상태의 변화와 영상 취득조건에 따른 분류 불확실성이 함께 포함된 결과로 해석할 필요가 있다. 이러한 한계에도 불구하고 본 결과는 고해상도 위성영상 기반 의미론적 분할 기법이 수위 상승 전·후의 하천 수변구역 토지피복 변화를 정량적으로 파악하는 데 활용될 수 있음을 시사한다.
5.3 연구의 한계 및 향후 과제
다만 본 연구에는 몇 가지 한계가 존재한다. 학습 및 검증 자료가 미호강 단일 하천 구간에 한정되어 있어, 하폭·하상재료·식생 구조·주변 토지이용이 상이한 다른 하천에 적용할 경우 편향이 발생할 수 있으며, 향후 금강·낙동강·한강 수계 등 다양한 하천 유형에 대한 일반화 성능 검증이 필요하다. 또한 수위 상승 전후 두 시점의 비교만으로는 관측된 면적 변화가 강우의 직접적 영향에 의한 것인지, 영상 취득 시기 차이에 따른 방사 특성 및 식생 상태 변화에 의한 것인지를 완전히 분리하기 어려우며, 강우량·수위·유량·선행강우량 등의 기상·수문 자료와의 연계 분석이 요구된다. 나아가 나지와 도로 클래스는 제방도로·포장면·건조한 모래톱 등의 분광 유사성으로 인해 오분류 가능성이 잔존하므로, LiDAR 지형자료·SAR 영상(Tarpanelli et al., 2022)·도로망 정보 등 보조 공간자료를 통합한 다중자료 기반 분류 체계 도입이 필요하다. 또한 본 연구에서 비교한 4개 모델은 인코더 백본의 파라미터 수와 연산량이 상이하여, 모델 간 성능 차이를 아키텍처 구조만의 효과로 완전히 분리하기 어려운 한계가 있다.
6. 결 론
본 연구에서는 PlanetScope 3 m 다중분광영상과 딥러닝 기반 의미론적 분할 모델을 활용하여 미호강 수변구역 265.8 ha를 대상으로 토지피복 자동 분류 체계를 구축하고, 2025년 수위 상승 전후의 토지피복 변화를 정량적으로 분석하였다. 특히 공간해상도가 상이한 자료를 결합하여 학습 라벨을 구축하는 과정에서 발생할 수 있는 라벨 불확실성을 완화하기 위해 Dynamic World와 환경부 토지피복도를 결합하고, 토지피복 경계부 화소 제거와 NDVI·NDWI 기반 분광지수 마스킹을 적용하였다. 이를 통해 경계부의 혼합화소와 각 토지피복 클래스의 분광 특성에 부합하지 않는 화소를 학습에서 제외하였으며, 다중 모델의 단순 성능 비교를 넘어 학습 라벨의 품질을 보완하고 이를 수위 상승 전후 수변구역 변화 분석에 적용하였다는 데 본 연구의 의의가 있다.
모델 성능 비교 결과, U-Net, Attention U-Net, DeepLabV3+, SegFormer를 동일한 조건에서 평가하였을 때 SegFormer가 OA 96.82%, mIoU 0.8275, mF1 0.8954로 가장 높은 종합 성능을 나타냈다. 수체·나지·목본 클래스에서는 U-Net이 일부 지표에서 소폭 우세하였으나, 도로 클래스 IoU (0.735)를 포함한 전체 평균 성능을 고려할 때 SegFormer가 하천 수변구역 내 선형 객체와 복합 피복의 공간 문맥을 가장 효과적으로 학습하는 것으로 판단되었다. 최적 모델인 SegFormer를 수위 상승 전후 영상에 적용한 결과, 수위 상승 후 수체 면적은 60.3%(+36.2 ha) 증가하고 나지 면적은 96.5%(-24.7 ha) 감소하였으며, 이는 수위 변동에 따라 하도 내 모래톱 및 노출 하상이 침수된 양상을 정량적으로 반영한 결과로 판단된다.
본 연구의 결과는 PlanetScope 고해상도 위성영상과 딥러닝 기반 의미론적 분할 모델을 활용하여 수위 상슨 전·후의 하천 수변구역 토지피복 변화를 정량적으로 파악할 수 있음을 보여준다. 향후 다양한 강우 및 수위 변동 사상과 하천 유형을 대상으로 적용성을 검토하고, 하천 수변구역의 토지피복 변화 모니터링 및 하천 관리 의사결정 지원 기술로 확장할 필요가 있다.